A Quick Start to RL
Preliminary
入门强化学习最开始可以花费5分钟时间熟悉基本概念,不需要死记硬背,仅需要把本节当作字典查询即可,大家可以快速预览后直接进入下一节,了解完代码流程后再返回来理解。
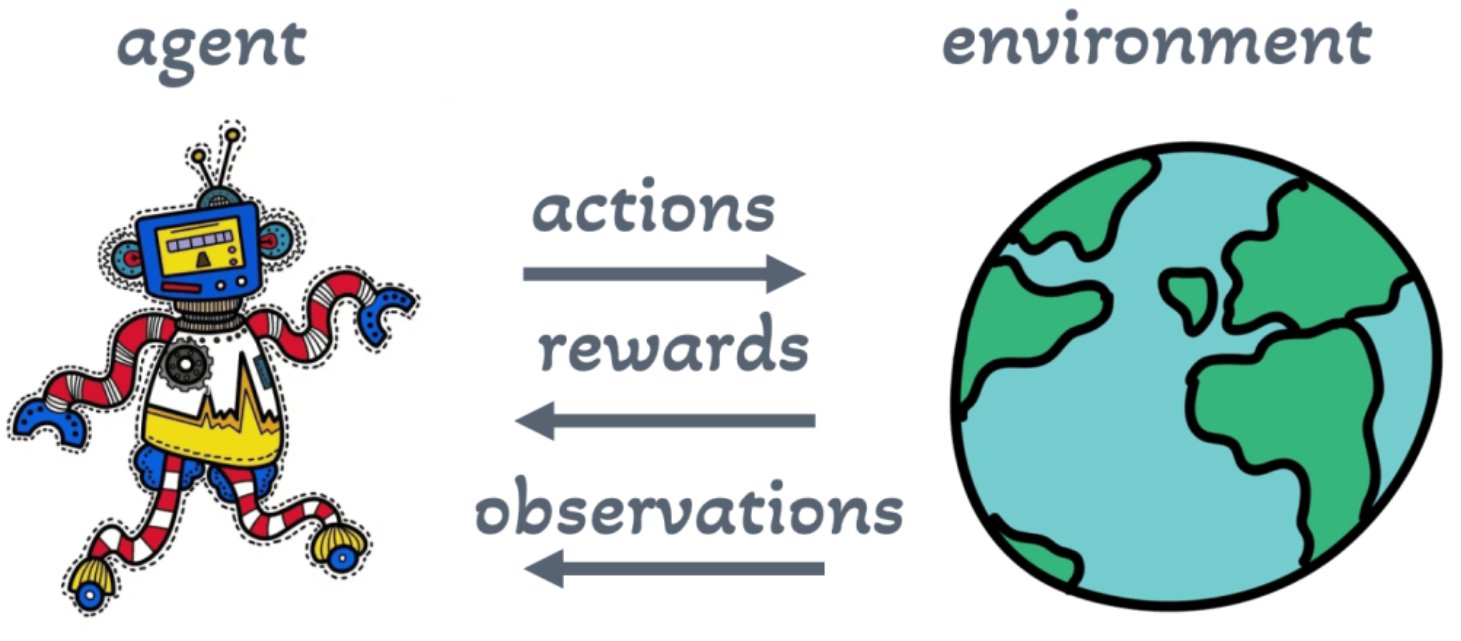
Basic elements
强化学习专注于学习如何基于环境的反馈作出最优决策,包含以下基本元素:
-
智能体(Agent):在强化学习(RL)框架中,智能体是指一个能够观察并与环境交互的实体。它通过执行动作并根据环境反馈(通常是奖励信号)来做出决策的系统。智能体的目标是学习如何选择动作以最大化长期累计奖励。
-
环境(Environment):环境是智能体所处的外部系统,它定义了问题的界限和规则。在强化学习中,环境接收智能体的动作并响应给出新的状态和奖励,这决定了智能体的学习过程。
-
状态(State,s):状态是对环境在特定时刻的描述或观察。它通常被视为智能体用来做出决策的信息集合。状态必须包含关于环境的足够信息,以便智能体能够有效地做出行动选择。
-
状态的概率密度函数(State Probability Density Function):状态的概率密度函数是一个数学函数,用于描述在给定当前状态和智能体的动作下,环境转移到各个可能下一状态的概率分布。这个函数是理解和预测环境动态的核心要素。
-
状态价值函数(State Value Function, V(s)):状态价值函数是一个函数,它给出了在策略π下,从状态s开始并遵循该策略所能获得的预期回报的估计值。状态价值函数是用于评估在某状态下开始并遵循特定策略所能达到的长期表现。
-
策略(Policy, π):策略是从状态到动作的映射。在确定性策略中,它定义了在给定状态下智能体将要执行的动作;在随机性策略中,它定义了在给定状态下选择每个可能动作的概率。
-
动作(Action,a):动作是智能体可以在给定状态下选择执行的任何操作。动作根据环境的反馈影响智能体所处的状态以及它接收到的累计回报。
-
动作的概率密度函数(Action Probability Density Function):这个函数描述了在给定状态和策略下,选择每个可能动作的概率分布。特别是在连续动作空间中,这个函数定义了所有可能动作的概率密度。
-
动作价值函数(Action-Value Function, Q(s,a)):动作价值函数或Q函数,给出了在策略π下,从状态s开始并采取动作a,然后遵循策略π所能获得的预期回报的估计值。它是评估在特定状态下执行特定动作并随后遵循特定策略的长期表现的关键。
-
回报(Reward):回报是环境根据智能体执行的动作给出的立即反馈。它是强化学习过程中引导智能体学习和行动选择的关键信号。
-
累计回报(Cumulative Reward):累计回报是从当前时刻开始到未来某个时间点或时序结束时,智能体获得的回报之和。它是强化学习中最关注的优化目标,智能体的学习和决策旨在最大化这个累计值。
-
探索(Exploration):探索是智能体尝试未知或较少尝试动作的过程,目的是发现更有价值的行动选择或信息,以改善其决策策略。
-
利用(Exploitation):利用是指智能体选择那些已知为产生最大回报的动作的过程。在利用中,智能体依赖已有知识做出决策,而非寻求新的信息。
-
轨迹(Trajectory):在强化学习中,轨迹是指智能体在与环境交互过程中经历的一系列状态(s)、动作(a)和奖励(r)的序列。
Types of methods
强化学习发展至今有着一系列的成熟算法,按照原理可以分为以下三类,后续发展的一系列算法大多是基于这三类方法的结合或变体,其思想还是一致的。
a. 基于价值的方法(Value-based method)
b. 基于策略的方法(Policy-based method)
c. 演员-评论家算法(Actor-Critic method)
关于强化学习的理论理解、方法基本原理、尤其是其随机性、延迟奖励、探索-利用平衡等重要机制的深入了解可以参考以下文献
[1] 强化学习(DRL)https://gnn\.club/?p=2212
[2] 强化学习导论 https://rl\.qiwihui\.com/zh\-cn/latest/chapter1/introduction\.html\#id4
[3] 王树森强化学习视频课程 https://www\.bilibili\.com/video/BV12o4y197US/?spm\_id\_from=333\.337\.search\-card\.all\.click\&vd\_source=c725842c03cd3122e46ae85e9e595cbe
Minimal RL
-
Minimal RL通过最简洁的RL实现使大家5分钟内入门RL并做简单测试。
-
我们基于PPO实现Minimal RL。PPO 是一种基于策略梯度的强化学习算法,通过限制策略更新的幅度来保证训练稳定性。对大多数任务而言稳定有效。
-
PPO Ref: Schulman J, Wolski F, Dhariwal P, et al. Proximal policy optimization algorithms[J]. arXiv preprint arXiv:1707.06347, 2017.
PPO (discrete action)
-
针对离散动作空间设计的PPO算法
-
以下代码测试环境CartPole-v1包含两个离散动作:动作0-向左推小车;动作1-向右推小车
超参数
-
定义
-
learning_rate: 0.0005,学习率
-
gamma: 0.98,折扣因子
-
lmbda:0.95,GAE 中的 λ 参数
-
eps_clip:0.1 ,PPO 中用于限制更新幅度的 clip 参数
-
K_epoch:3,每次采样数据后训练的轮数
-
T_horizon:20,每次采样的步数、
-
-
调整思路
-
learning_rate:学习率,太大可能导致不稳定
-
gamma:接近 1 表示更关注长期回报
-
eps_clip:控制策略更新幅度,通常 0.1~0.3
-
T_horizon:更大的值意味着更多数据但更新延迟
-
PPO类
-
网络结构
-
输入层:4 维(CartPole 状态)
-
隐藏层:256 个神经元,使用 ReLU 激活
-
输出层:
-
pi:策略网络,输出 2 个动作的概率
-
v:价值网络,输出状态价值
-
-
-
方法说明
-
pi(x, softmax_dim):输入状态,输出动作概率分布
-
v(x):输入状态,输出状态价值
-
put_data(transition):存储交互数据
-
make_batch():将存储的数据转换为 Tensor
-
train_net():执行 PPO 训练步骤
-
训练流程
-
创建环境和模型
-
循环多个回合(episode)
-
每个回合中:
-
重置环境
-
执行 T_horizon 步交互,存储数据
-
调用 train_net() 更新网络
-
-
每 100 回合打印平均得分
PPO (continuous action)
-
针对连续动作空间设计的PPO算法
-
以下测试环境Pendulum-v1的动作空间是连续的:一个[-2.0, 2.0]的区间,为施加在摆杆上的扭矩大小
超参数
-
定义
-
learning_rate:0.0003,学习率
-
gamma:0.9,折扣因子
-
lmbda:0.9,GAE 中的 λ 参数
-
eps_clip:0.2,PPO 中用于限制更新幅度的 clip 参数
-
K_epoch:10,每次采样数据后训练的轮数
-
rollout_len:3,每个 rollout 的长度
-
buffer_size:10,缓冲区大小
-
minibatch_size:32,小批量大小
-
-
调整思路
-
learning_rate:学习率,太大可能导致不稳定
-
gamma:接近 1 表示更关注长期回报
-
eps_clip:控制策略更新幅度,通常 0.1~0.3
-
rollout_len:数据收集频率
-
PPO类
-
网络结构
-
输入层:3 维(Pendulum 状态)
-
隐藏层:128 个神经元,使用 ReLU 激活
-
输出层:
-
mu:动作均值,使用tanh缩放至[-2, 2]
-
std:动作标准差,使用softplus保证正值
-
v:价值网络,输出状态价值
-
-
-
方法说明
-
pi(x, softmax_dim): 输入状态,输出动作的均值和标准差
-
v(x): 输入状态,输出状态价值
-
put_data(transition): 存储rollout数据
-
make_batch(): 创建训练批次(包含缓冲区和小批量处理)
-
calc_advantage(data): 计算优势函数
-
train_net(): 执行 PPO 训练步骤
-
训练流程
-
创建Pendulum环境和模型
-
循环多个回合(episode)
-
每个回合中:
-
重置环境
-
执行最多200步交互
-
每rollout_len步存储一次数据
-
调用train_net()更新网络
-
-
每20回合打印平均得分和优化步数
Network-oriented RL
-
能快速运行的、最简洁版本的、适配于基本ABR传输的RL框架
-
需对自适应传输稍有基础,例如能理解core.py的逻辑
代码说明
-
envivio:测试视频每个chunk的每个码率的data size记录
-
traces:训练使用的网络跟踪
-
core.py:模拟视频下载过程,即:在某一traces下,以某一quality下载下一个video chunk,所导致的状态变化,如QoE、缓冲区、重缓冲事件以及下一次下载时的网络状态等。
-
env.py:将core封装成RL所需环境,包含reset()和step()等
-
load_trace.py:从给定traces文件中读取带宽序列
-
ppo2.py:创建ppo模型
-
train.py:在env中使用ppo模型进行训练
如何复用到其他传输任务
-
修改环境,即core.py和env.py。读取带宽和模拟下载的方式可酌情保留。
-
修改train.py
-
action(输出)和state(输入)的维度和定义。
-
reward(通常为标量)
-
交互方式。与env.py中的step和core.py中的get_video_chunk对齐。
-
-
修改ppo2.py中的网络结构,使其与train.py中action和state的维度对齐。一些要点
-
网络吞吐量、下载延迟等网络指标通常考虑历史多个状态作为向量特征处理(如ppo2.py中split_2和split_3)。可考虑使用cnn和rnn等具有更强特征提取能力的网络
-
上一码率,缓冲区状态,剩余chunk数量通常用当前状态作为标量特征处理(如split_0、split_1和split_5)
-
未来候选码率通常作为长度为a-dim的向量特征处理(如split_4)
-
merge_net也要对应修改
-
PPO的loss和权重更新等可保留
-
Coding-oriented RL
-
对于编码,与上述传输任务的主要区别在于环境和奖励的设计不同,在RL的方法上是基本一致的
-
RL在编码过程中的作用位置可以分为in-loop和out-of-loop两种:
-
in-loop:目的就是为了优化编码器本身,比如寻找更优的分层质量结构、寻找不冲突的梯度更新方向、寻找多优化目标的最优权重组合等等。在这种任务中,无模型的方法更加直接方便与编码器一起训练,如REINFORCE、REINFORCE++
-
out-of-loop:目的是为了在编码器外集成额外的planners,比如码率控制时一个调整帧级QP的Agent、GoP结构分配的Agent等等。将编码器看作一个固定的黑盒子,然后联合其训练,设计出调整其接口参数、编码策略参数的网络。在这种任务中,编码器参数固定,可以使用有模型的方法来定义一个planner,如一些Actor-Critic的方法:SAC、PPO等
-
-
下面以 1. REINFORCE算法帮助正则化DHVC的层间码率分配 和 2. SAC算法在编码器外做码率控制planner 两个例子代码和标准的两个算法代码对比来介绍
- 简明的 CartPole-v1 环境验证的纯净代码:这个环境想让这个小块上的竖直杆子在小块左右移动时保持竖直不倒
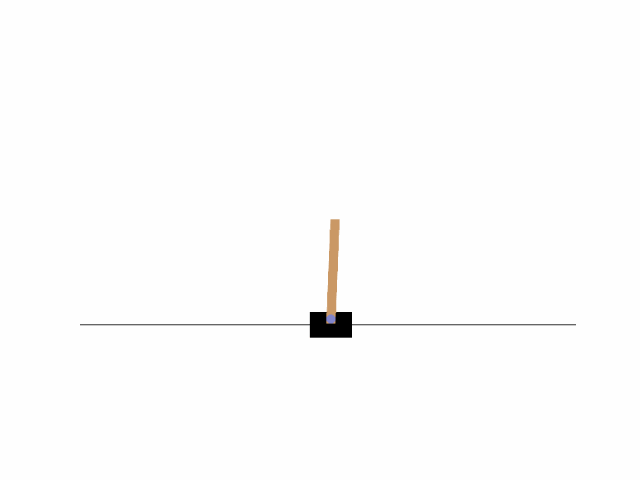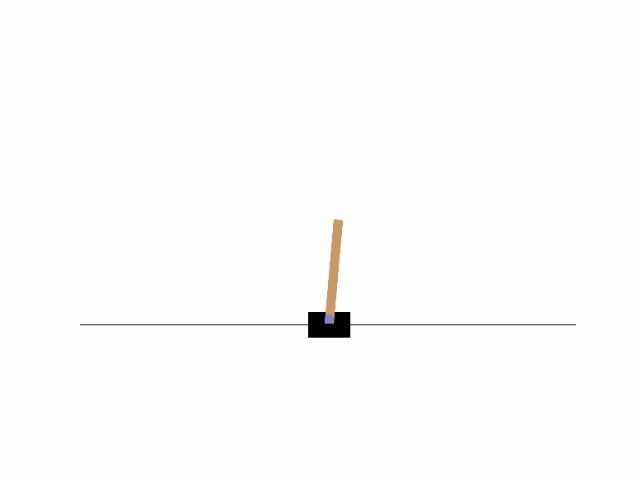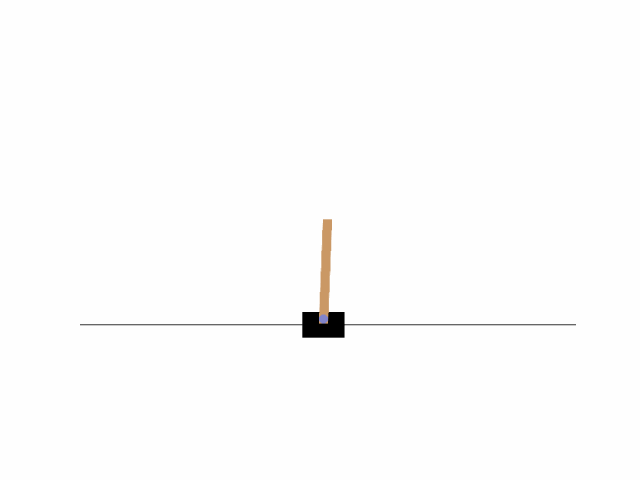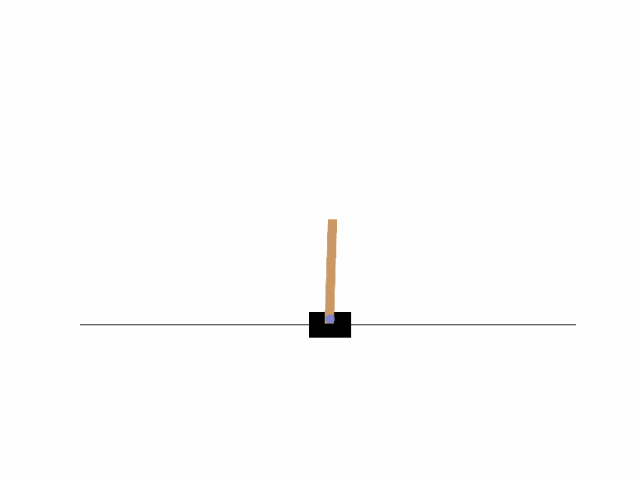
上述代码仅是简单地搭建了强化学习算法的pipeline,其主要代码构成包括:
环境类
-
__init__()环境变量
-
reset()函数每条轨迹结束后重置
-
step()函数每条轨迹的每一步
-
计算reward函数
…
模型类
-
Policy模型
-
Value模型
-
Policy/Value Delay模型用于延迟软更新
…
训练/测试类
-
sample函数 采样轨迹
-
get_data / replay_buffer得到用于训练的轨迹样本
-
trainer()各算法的不同训练流程
-
tester()各算法的不同测试流程
-
但实际上的环境动态更加复杂,有着较大的状态和动作空间,且伴有很强的随机性,上述的代码仅仅对于一个非常简单的游戏环境做的一个Toy示例。实际应用时,为了更高效稳定地训练,后续的大量算法逐渐在这种基础算法上集成了许多的Tricks和Hyperparameters,如:
-
Experience replay
-
Target network
-
Soft update
-
Gradient clipping
-
Reward clipping
-
Prioritized Experience Replay (PER)
-
Leanable entropy regularization coefficient
-
Generalized Advantage Estimation (GAE)
-
Dueling network architecture
-
Ornstein–Uhlenbeck noise
-
- 对比在编码环境中的代码应用:
还在整理 Coming Soon…
How to Customize RL Solvers
延续着上面,以编码任务为例:
-
首先分析我们的任务是不是可以建模成一个马尔可夫序贯决策过程:当前决策的最优动作是否仅与当前能观测到的状态相关,且这个动作带来的奖励是可以明确地、合理地定义的;
-
分析出三个最重要的要素:状态如何建模(最优动作都与什么有关都加进来,如何统一这些状态信息,如何从这些原始的状态中进一步提取、建模)、动作包括什么(动作有几类、分别是离散的还是连续的、规模是否需要网络建模,有没有什么明确的物理意义定义了其概率分布函数)、奖励如何设计(奖励是稀疏的还是稠密的,比如迷宫游戏找到出口才能+1分就是稀疏的,在一条轨迹的最后才能拿到一个奖励;比如超级玛丽吃到金币+1分,踢死小乌龟+2分,解救成功公主+999分,被食人花吃了-100分等等,在一条轨迹中很多时刻甚至每个时刻都有不同的奖励;奖励是基于规则手动定义的比如上述的两种,或是启发式的比如同样是码率控制算法RL实现的精度比传统编码器自带的高就+1分,低就-1分,或是基于模型反馈的,比如RLHF的模型会给一个分数作为奖励,还有对于OOD情况的大惩罚比如码率控制时发生提前把能分配的码率用光了导致码率溢出-100分;还有代表不同意义的奖励如何加权);
-
梳理出与环境交互的逻辑,比如编码任务每一帧编码过程对应一个轨迹中的一个时刻的话,那么状态在哪里提取、动作对应在哪里采样产生、奖励在哪里计算、怎么样算一个完整的轨迹…
-
上面都梳理好了之后,开始选择RL算法,首先简单地根据动作是否连续,是否需要显式的模型建模等等筛选。
-
离散动作空间推荐:Dueling DoubleDQN(D3QN)
-
连续动作空间推荐:擅长调参就用TD3,不擅长调参就用PPO或SAC,如果训练环境 Reward function 都是初学者写的,那就用PPO
-
-
搭建完整代码:环境、模型、训练、测试,并初步训练一小段时间
-
根据模型gradient(是否梯度爆炸,消失)、reward曲线(是否在训练前期快速稳定的上升)、state分布(是否有统一、合理的值范围,是否符合一些先验知识,比如哪些是正相关哪些是负相关是有区分的)、action分布(是否合理比如全是单一action而不选择其他的说明有问题,是否符合一些先验知识)来调整1. 模型结构保证梯度正常反传,尤其时经过一些特殊的激活函数后值范围仍合理 2. 奖励函数合理有效
-
经过6后保证至少模型是在前期能正常训练了,状态-动作-奖励都是基本合理的,接着是在训练过程中也要仔细盯着上面一些训练的信息。那么当收敛到最后时,分析收敛的好坏判断是否需要进一步1. 微调奖励 2. decay学习率 3. 微调一些超参数和技巧,比如探索力度的衰减 4. 切换/扩充数据集进一步微调。
-
不同算法具体的进阶调参技巧,一般情况下如果没有明确的环境先验知识指导,尽量不需要修改成熟代码框架中的超参数:
[1] 如何选择深度强化学习算法?https://zhuanlan\.zhihu\.com/p/342919579
[2] 深度强化学习调参技巧 https://zhuanlan\.zhihu\.com/p/345353294
To Be Explored
-
在线强化学习
-
Diffusion Policy